凌晨两点,支付回调队列的 Worker 又 OOM 了。这台 8G 内存的机器上,queue:work 进程跑满 72 小时后,RSS 从启动时的 210M 一路爬到 3.2G,最后被内核 OOM Killer 干掉。
重启、再跑、再挂,循环了三次,每次都是同一台机器、同一个进程。这不是玄学,是 PHP-CLI 常驻进程最典型的内存泄漏现场。
这篇文章用这一个案例,把从告警到定位、再到修复验证的完整路径走一遍——不重复"打 memory_get_usage 日志"那套入门玩法,只讲线上真正管用的东西。
先分清:这是泄漏,还是峰值
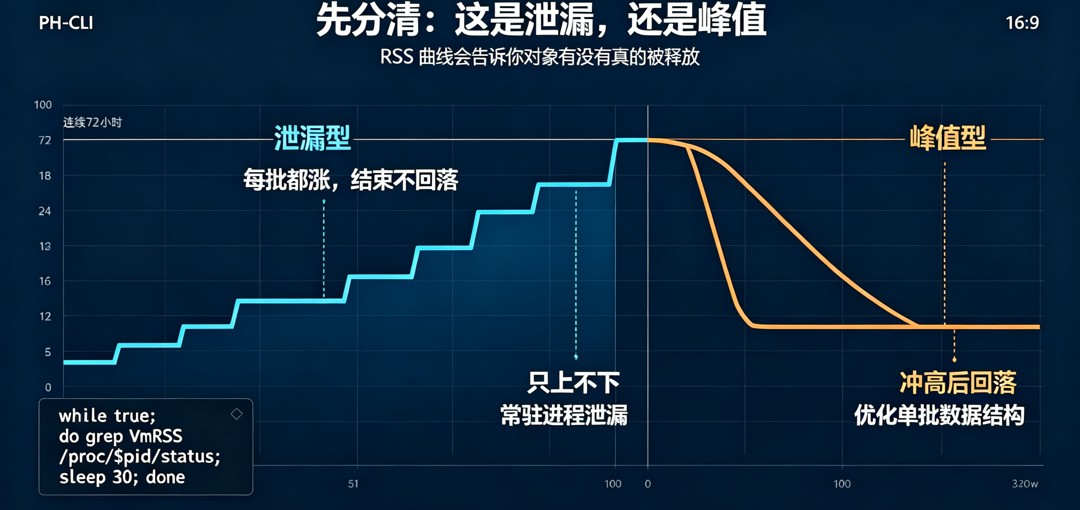
接手第一件事不是抓内存,而是看 RSS 曲线。泄漏和峰值长得完全不一样,抓错对象后面全白干。用一条命令盯住进程的 RSS 阶梯:
while true; do
  pid=$(pgrep -f 'queue:work' | head -1)
  [ -n "$pid" ] && grep VmRSS /proc/$pid/status | awk '{print strftime("%H:%M:%S"), $2/1024 "MB"}'
  sleep 30
done
连续盯了两个小时,曲线出来了:每处理一批回调,RSS 涨一截,批次结束不回落,下一个批次又在更高的基础上继续涨。
这是标准的"只上不下"阶梯,泄漏坐实了。
如果是峰值型,RSS 会随批次冲高再回落,那要优化的是单批数据结构,方向完全不同。这一步定了,才进入快照定位。
快照定位:内存 diff 一定要抓对作用域
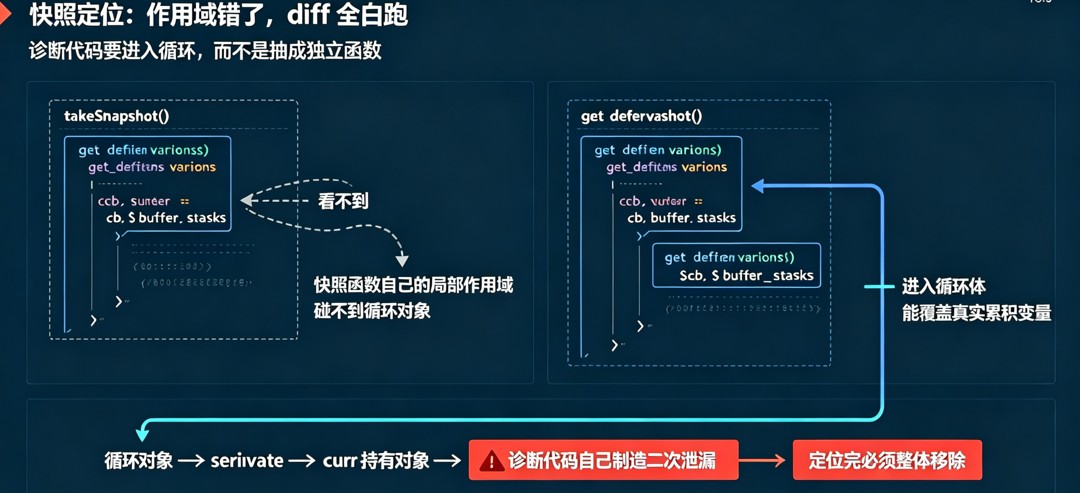
定位"涨在哪",本质是拿两个时间点的内存快照做差。这里有个新手必踩的坑:get_defined_vars() 只能拿到它自己所在作用域的变量。
把它包进一个独立函数里,抓到的只有那个函数的局部变量,永远碰不到循环里的 $tasks、$buffer 这些真正的泄漏对象。很多人栽在这,跑半天 diff 全是一条条"无变化"。
要抓对作用域,得让快照逻辑直接在循环体内展开,而不是抽成函数:
$prev = [];

foreach ($callbacks as $i => $cb) {
    consume($cb);

    if ($i % 500 === 0) {
        $curr = [];
        foreach (get_defined_vars() as $name => $value) {
            if ($name === 'prev' || $name === 'curr') {
                continue; // 跳过快照变量自身,避免自引用
            }
            $curr[$name] = strlen(serialize($value));
        }

        foreach ($curr as $name => $size) {
            $delta = $size - ($prev[$name] ?? 0);
            if ($delta > 1048576) {
                echo "LEAK? {$name} +{$delta} bytes\n";
            }
        }
        $prev = $curr;
        gc_collect_cycles();
    }
}
注意两个细节。第一,get_defined_vars() 必须写在循环体里,作用域才覆盖 $cb、$buffer 这些累积变量;第二,必须把 $prev、$curr 自己跳过,否则快照变量会反向持有所有被 serialize 的对象。
这第二点背后有个关键机制,正是线上排查里最阴的一环:serialize 一个对象时,会递归遍历它的所有属性并建立引用,而 get_defined_vars() 返回的数组本身就持有每个变量的引用。
于是快照数组 $curr 成了所有对象的"新主人",让本该在循环末尾释放的对象被 $curr 死死抓住,诊断代码反而制造了新的泄漏。
所以这份快照逻辑只用于排查,定位完必须整体移除,绝不能留在生产循环里——本地你随时重启无所谓,线上进程一重启就是一批在途订单回调延迟。
diff 结果指向一个静态数组
快照跑了两轮,输出里反复出现同一个名字:
LEAK? buffer +524288 bytes
LEAK? buffer +1048576 bytes
LEAK? buffer +2097152 bytes
翻到 consume() 的实现,根因找到了。为了防止回调重复处理,代码把"已处理的回调 ID"塞进了一个静态成员做去重,而这个静态数组从不清空:
class CallbackDedup
{
    private static array $handled = [];

    public static function isHandled(string $id): bool
    {
        if (isset(self::$handled[$id])) {
            return true;
        }
        self::$handled[$id] = true; // 静态属性,进程不死,永不释放
        return false;
    }
}
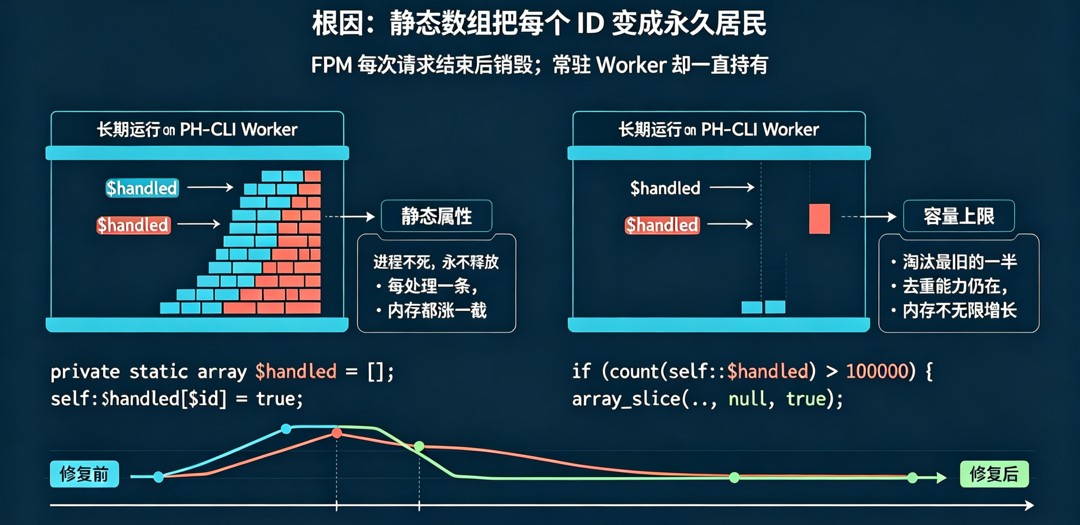
静态属性和单例的生命周期跟进程一样长。回调一天几十万条,这个 $handled 数组每天吞掉几百 MB 内存,且永远不会触发回收。
这解释了为什么 RSS 是"只上不下"的阶梯——每个回调 ID 都是永久居民,没有一条会被赶走。
这也正是常驻进程和请求型 PHP-FPM 的本质区别:FPM 每次请求结束进程退出,静态成员跟着销毁,你永远感知不到这个泄漏;只有常驻 Worker 会把这种"看似无害"的写法放大成 OOM。
修复:不是删去重,而是给去重加生命周期
修复的方向很多人会搞错——不是把去重逻辑删掉,那样会引入重复扣款、重复回调的更大问题。
正确的做法是让这个"永久居民"变成"有期限的居民"。回调去重只需要挡住短时间内的重复通知,不需要记住历史上一整年的 ID,所以把它换成带过期时间的外部存储,或给静态数组加容量上限:
class CallbackDedup
{
    private static array $handled = [];

    public static function isHandled(string $id): bool
    {
        if (isset(self::$handled[$id])) {
            return true;
        }

        // 容量上限:超过 10 万条,淘汰最旧的一半
        if (count(self::$handled) > 100000) {
            self::$handled = array_slice(
                self::$handled,
                (int)(count(self::$handled) / 2),
                null,
                true
            );
        }

        self::$handled[$id] = true;
        return false;
    }
}
上线后重跑,RSS 曲线立刻变了:处理一批涨一截,批次结束回落到 210M 基线附近,阶梯从"只上不下"变成"有起有落"。
再压测了 50 万条回调,RSS 稳定在 240M 以内,泄漏消失。
最后把循环里的快照诊断代码整体移除,确认没有留下 serialize 自引用,才算真正收尾。
三条排查铁律
把这条案例沉淀成三条可以直接套用的规则:
第一,先分泄漏还是峰值——看 RSS 是否只上不下,方向错了后面全错。
第二,快照要抓对作用域——get_defined_vars() 写在循环体里,且跳过快照变量自身,否则 diff 抓不到对象,甚至诊断代码自己变成泄漏源。
第三,静态/单例是头号嫌疑——常驻进程里凡是往静态数组 append 却不设上限的,迟早 OOM,修复思路是"加生命周期"而不是"删功能"。
最后补一句站内相关的:这套排查路径在支付系统的回调消费者、对账 Worker 这类常驻进程里尤其要盯,因为这些进程一跑就是按月计,重启一次意味着那批在途订单要重新消费。
与其半夜被 OOM 叫醒,不如把 RSS 做成监控指标、设好告警阈值,让内存在爬坡阶段就被看见,而不是等它爬到 3.2G 才动手。